

导语
当今,在线媒体成为巨量用户交流的重要平台,构成了超级海量的数据,而且其结构往往是非结构性的。
在这当中,突发话题尤其值得特别加以关注。因为它们不仅具有现实意义,而且难以估量的潜在性的意义;不仅涉及到舆情的走向,还涉及到公关安全的问题。因此,有效区分普通话提和突发话题的意义,不可小觑。
一般的话题模型,在不加入先验信息的情况下,是很难有效区分普通话题和突发话题的。
本文的研究提出基于高效用模式和话题模型的突发话题发现(High Utility Bursty Topic Model,HU-BTM) 模型。该模型使用高效用模式挖掘找出文本数据中的突发词组,使用基于普通Pólya坛子模型的Gibbs抽样方法,将突发词组与突发词引入话题模型,实现突发话题的自动识别。
实验结果表明与现有的主要突发话题发现方法比较,HU-BTM 模型在准确率和召回率指标上优于对比算法。
一、研究背景与意义
随着天涯社区、微博、微信等日益普及,在线媒体渗透日常生活的各个方面,成为人们在获取信息、交换意见、表达观点的重要渠道。公众不仅通过在线媒体上分享日常生活和表达情感,而且对热点话题表达观点,如腐败问题、环境污染、经济发展、社会文化、国家安全和国际关系等社会热点。在线媒体也是社会突发话题曝光的主要渠道,如P2P公司破产话题、留守儿童问题、重大生产安全事故、药品质量安全事故、医患纠纷等。在线媒体是突发话题传播的途径,不仅可以扩大突发话题的传播范围,而且可以扩大突发话题的影响力,对政府执政、企业管理和人们日常生活产生巨大影响。因此,从海量的在线媒体数据中对突发话题进行识别和追踪,可以帮助政府、企业、公民更加便捷的掌握社会动态,提高政府的社会治理水平和人们的生活质量。然而在线媒体不仅包括海量的非结构数据, 而且大部分话题属于闲聊式日常话题,内容变化较小,从在线媒体中快速的识别和追踪突发话题成为一项具有挑战性的任务。
突发话题发现的研究起源于话题检测与追踪技术(Topic Detection and Tracking, TDT),主要从传统新闻媒体中发现突发话题,并对突发话题进行持续的追踪。在TDT研究中,事件是指由与特定时间、地点、人物等关联的,并伴随某种结果的具体社会活动,话题是指与种子事件相关联的所有事件的集合. 突发事件指突然发生的,造成或者可能造成严重社会损害的自然灾害、事故灾难、公共卫生事件和社会安全事件。突发话题是与突发事件关联的话题,单个突发话题可以包括单一突发事件,也可以包括多个突发事件。在线媒体的突发话题的出现往往伴随着与该话题相关的发帖集中出现,点击量和阅览量激增,是社会公众的讨论的焦点。在线媒体发帖量随时间的变化特征在突发话题检测中应用广泛。
现有的突发话题发现模型大部分需要提供文本数据以外的信息,如时间信息、用户互动信息、情感信息等,应用范围存在一定的局限。虽然词语的相似性和词语的突发性等在一定程度上可以提高话题模型的效果,但是突发词组拥有更多的突发信息,能够更好表示突发话题。高效用模式挖掘是在频繁模式挖掘的基础上发展起来的,通过定义词语的内部效用和外部效用从海量在线媒体数据流中发现突发词组。本文的研究尝试使用高效模式挖掘从文本数据中获取高效用项集,也就是突发词组。通过改变文档话题先验的生成方式和词语话题分布的Gibbs 抽样算法,提出HU-BTM模型,多角度的提高主题模型在突发事件的有效性.
二、模型与实验
本文提出融合高效用模式的突发话题发现方法,框架如图1所示。该框架包括数据预处理、生成先验信息、HU-BTM 建模和突发话题发现四个部分。数据预处理包括去除噪声数据、去除停用词和使用TFIDF提取关键词等操作,可以提高语料库的质量。先验信息对提高模型效果有很重要意义,研究使用高效用项集获得语料库的突发词组,通过对单个事件窗口的词语的频次与整个语料库词语的平均频次比较计算词语是突发词的概率。为了将高效用项集纳入模型, 研究使用普通Pólya坛子模型对HU-BTM模型进行Gibbs抽样。最后本文对突发话题和背景话题进行分析,对HU-BTM模型的效果进行评估.
(1)在线媒体的高效用模式计算
高效用模式挖掘(high utility pattern mining)引入内部效用、外部效用和事务加权效用等概念,从事务数据库挖掘出频次和价值均较高的项集。突发话题发现的研究通过高效用模式挖掘识别在线媒体数据中的高效用项集,内部效用使用句子中词语的频次表示,外部效用使用相邻时间窗口中词语的频次变化率表示。闭高效用集不仅可以减少高效用集的数量,而且与主题模型的结合效果良好,本文使用CHUD算法计算语料库的闭高效用集.
(2)HU-BTM模型构建
传统的话题模型基于词袋模型假设,通过词共现的方式学习语料库中的话题,并以词向量的形式表示出来。然而共现最多的词语往往是普通的词语,会影响话题模型在突发话题发现的效果。突发话题往往伴随着突发词语的出现,如在长生生物疫苗造假事件中,“长生”、“疫苗”、“产品”和“长春”等词语同时爆发性出现,意味着突发话题的出现。本研究引入高效用模式从媒体数据流中挖掘突发的词组,将其作为先验信息输入HU-BTM模型,实现突发话题的挖掘.
在线媒体的话题分为突发话题和背景话题。突发话题是内容的数量在整个媒体中短时间内急剧增长的话题,是当前社会关注的热点。背景话题则是长期存在的常规话题,内容数量保持稳定。研究设置语料库包含K个突发话题,1个背景话题,每个词语w通过开关变量y选择突发话题与背景话题。高效用项集包含多个词语,这些词语属于同一个话题。本文通过引入高效用项集影响话题模型的文档话题分布和话题词语分布。每个文档d都可以表示为H 维二元向量l_d,如果高效用项集在文档中,则二元向量相应的参数为1,否则为0.模型生成H个狄雷克雷分布,文档对应的二元向量l_d相似度越高,文档话题分布的先验分布是相同的先验分布π_h的概率越高。此外,模式使用基于普通pólya坛子模型Gibbs抽样算法进行参数估计。HU-BTM模型如图1所示。
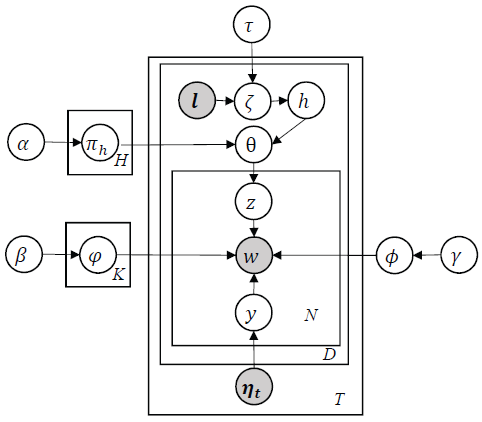
图1 HU-BTM 模型概率图表示
(3)实验结果分析
为了评估研究模型的效果,研究使用了两个真实的数据集:天涯杂谈数据集Twitter数据集.天涯杂谈是天涯社区的核心板块,对社会重大突发话题的关注和跟踪非常及时,甚至很多重大突发话题首先在天涯社区曝光,是研究社会舆情和突发话题发现的有力工具[45].研究使用Java爬虫收集了天涯社区天涯杂谈版块2018年全部的首发帖共126,939条。Twitter数据集收集了2012年3月6日至7日美国大选“超级星期二(Super Tuesday)”期间的712,403条数据。研究的数据数据预处理包括: 去除空贴、广告贴; 去掉URL、表情符、特殊字符等; 讲英文字符转化为小写; 去除天涯杂谈数据集中词语频率和文档频率小于20的词语,去除Twitter数据集中词语频率和文档频率小于10的词语; 建立包括地址、人名和事件名等在内的保留词典,去除停用词。最后经过处理的天涯杂谈数据集包括104,138条首发贴,Twitter数据集包括466,143 条发帖.
为了对HU-BTM模型突发话题发现的效果进行评价,研究引入准确率和召回率指标。准确率是模型发现正确的突发话题与总发现的突发话题的比值,召回率是发现的正确的突发话题与语料库标准的总的突发话题的比值。为了保证模型评估的有效性,研究对模型生成的话题采用人工标注。标注人员通过查阅话题对应的新闻报道确定该话题是否为突发话题,只有当一半以上的标注人员认为是突发话题的话题才被认定为突发话题。最后研究将OLDA模型、BBTM模型、RIBS模型和HU-BTM模型的发现的全部突发话题作为数据集真实的突发话题数量.
在天涯杂谈数据集中,当HU-BTM在话题为20、30和40时,准确率均超过0.8,优于基线模型。从召回率指标来看,HU-BTM模型的表现也较为稳定,随着话题数量的增加,模型的召回率不断提高。在Twitter数据集中,HU-BTM模型在短文本处理中也有较好的表现,准确率和召回率均优于OLDA模型、BBTM 模型和RIB模型。OLDA模型没有加入先验的突发信息,所以在突发话题的发现上表现较差。BBTM模型在话题模型中增加突发词先验信息,RIBS 模型增加LSTM神经网络学习的词语关系先验信息,均可以提高突发话题发现的准确率。然而BBTM模型仅增突发词信息,RIBS 模型增加的词语关系不能体现突发关系,HU-BTM模型将突发词先验信息和突发词组先验信息融入模型,可以更好的发现在线媒体中的突发话题.
三、结论与政策建议
在线媒体的发展伴随着海量的非结构的文本数据,存在着大量的噪声信息,不仅包括广受关注的突发话题,而且包括大量的闲聊式话题。突发话题与社会热点事件关联,是当前舆论的焦点,反映了社会民意、关系社会稳定和政府的执政。快速、准确的获取在线媒体中的突发话题,及时掌握社会舆论动态,对突发话题进行及时的应对,对提高政府治理、媒体管理有着很重要的意义。本文提出基于高效用模式和主题模型的突发话题发现方法,通过计算在线媒体文本数据流的高效用模型挖掘突发词组,通过改变主题模型文档主题分布的先验分布的生成方式和引入基于普通Pólya 坛子模型的Gibbs 抽样方法,将突发词和突发词组的先验信息纳入主题模型,提出HU-BTM 模型,实现更好的挖掘在线媒体的突发事件。实验结果表明,HU-BTM 模型在准确率和召回率连个指标均优于基准模型。
本文摘编自《系统工程理论与实践》第41卷第5期论文《融合高效用模式的在线媒体突发话题发现》,点击链接下载全文:http://www.sysengi.com/CN/abstract/abstract112746.shtml
作者:闫志华,中国科学院数学与系统科学研究院,博士,研究方向 数据挖掘与决策支持;唐锡晋,中国科学院大学,博士生导师,研究方向 综合集成,决策支持系统,知识科学。